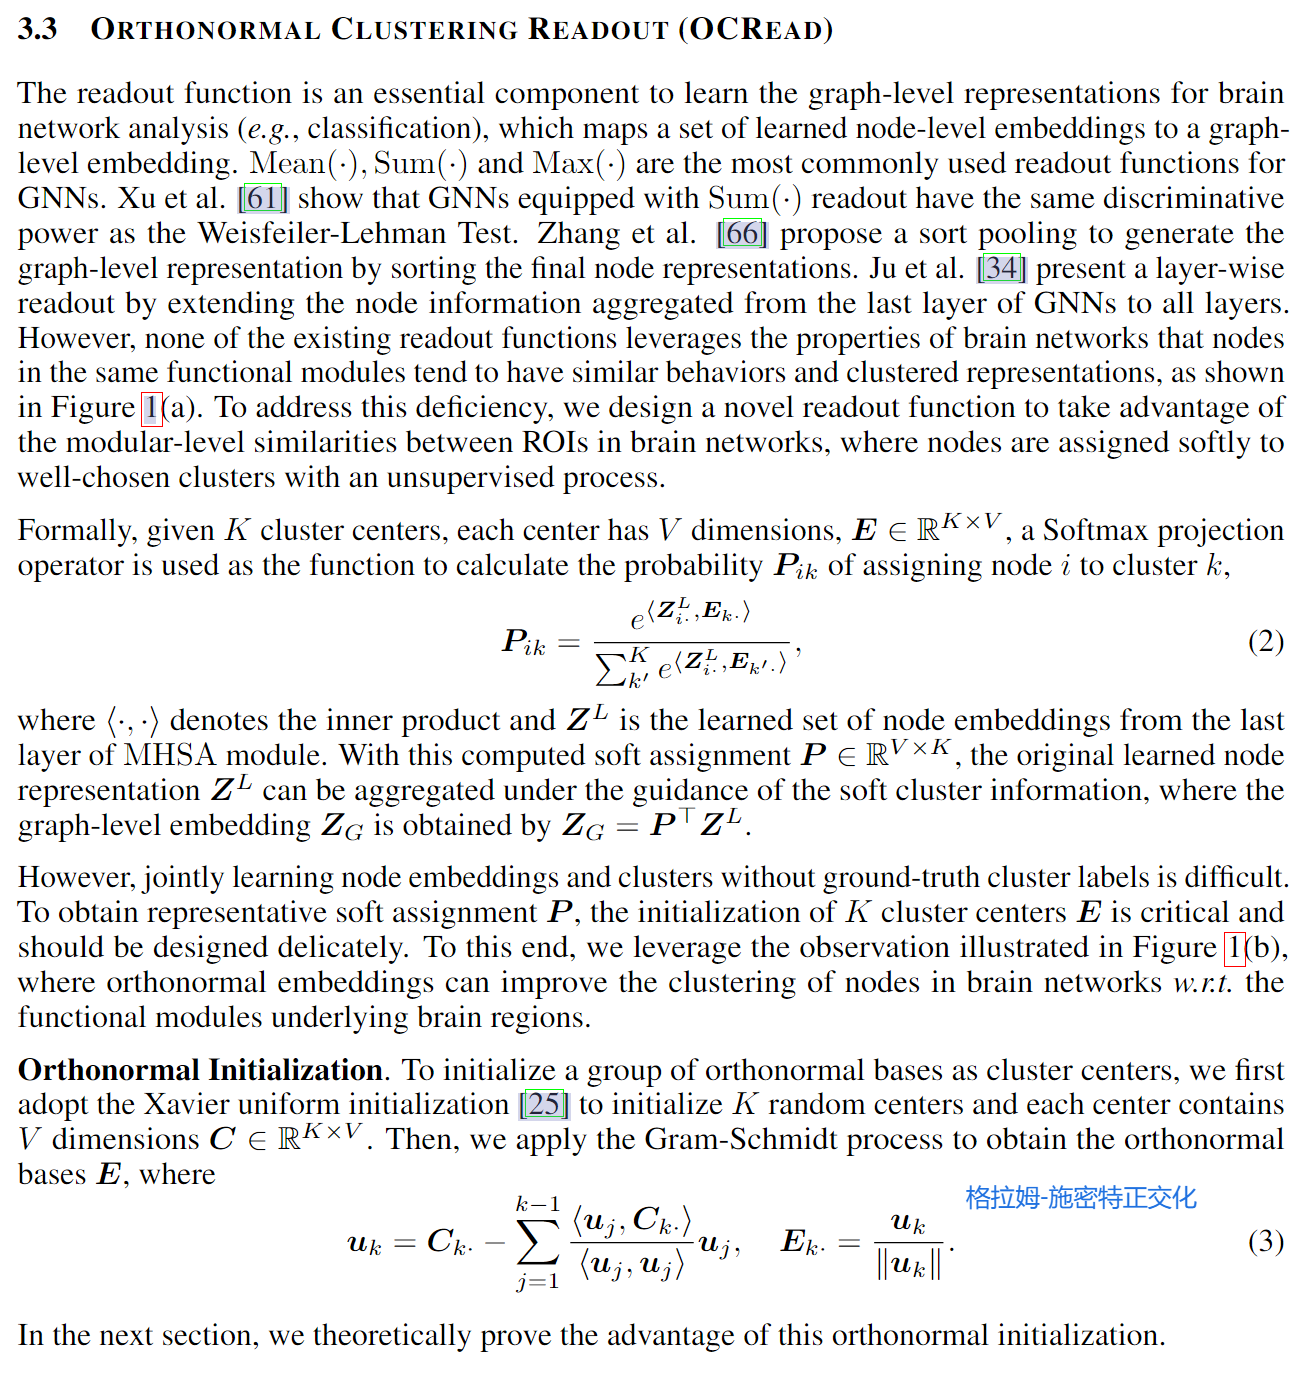
Brain Network Transformer里的正交聚类模块很实用,用到了Gram-Schmidt process。

Gram-Schmidt 过程

1. 定义

Gram-Schmidt 过程是一种将线性无关的向量组转换为正交归一基的方法。具体来说,给定一组线性无关的向量 {v1,v2,…,vn}\{v_1, v_2, \ldots, v_n\},Gram-Schmidt 过程可以生成一组正交归一基 {u1,u2,…,un}\{u_1, u_2, \ldots, u_n\},使得这两个向量组张成的子空间相同。

2. 步骤

假设我们有一组线性无关的向量 {v1,v2,…,vn}\{v_1, v_2, \ldots, v_n\},Gram-Schmidt 过程的具体步骤如下:

  1. 初始化第一个正交向量:

    w1=v1w_1 = v_1

    u1=w1∥w1∥u_1 = \frac{w_1}{\|w_1\|}

  2. 递归生成后续正交向量:
    对于每个 ii 从 2 到 nn,计算:

    wi=vi−∑j=1i−1⟨vi,uj⟩⟨uj,uj⟩ujw_i = v_i - \sum_{j=1}^{i-1} \frac{\langle v_i, u_j \rangle}{\langle u_j, u_j \rangle} u_j

    ui=wi∥wi∥u_i = \frac{w_i}{\|w_i\|}

    其中,⟨⋅,⋅⟩\langle \cdot, \cdot \rangle 表示内积。

3. 具体公式

具体公式可以表示为:

w1=v1,u1=w1∥w1∥w_1 = v_1, \quad u_1 = \frac{w_1}{\|w_1\|}

wi=vi−∑j=1i−1⟨vi,uj⟩⟨uj,uj⟩uj,ui=wi∥wi∥for i=2,3,…,nw_i = v_i - \sum_{j=1}^{i-1} \frac{\langle v_i, u_j \rangle}{\langle u_j, u_j \rangle} u_j, \quad u_i = \frac{w_i}{\|w_i\|} \quad \text{for } i = 2, 3, \ldots, n

4. 矩阵形式

如果将这些向量组成矩阵 AA,其中每一列是一个向量 viv_i,那么 Gram-Schmidt 过程可以表示为矩阵分解:

A=QRA = QR

其中,QQ 是一个列向量为正交归一基的矩阵,RR 是一个上三角矩阵。具体来说:

A=[∣∣∣v1v2⋯vn∣∣∣]=[∣∣∣u1u2⋯un∣∣∣][r11r12⋯r1n0r22⋯r2n⋮⋮⋱⋮00⋯rnn]A = \begin{bmatrix} | & | & & | \\ v_1 & v_2 & \cdots & v_n \\ | & | & & | \end{bmatrix} = \begin{bmatrix} | & | & & | \\ u_1 & u_2 & \cdots & u_n \\ | & | & & | \end{bmatrix} \begin{bmatrix} r_{11} & r_{12} & \cdots & r_{1n} \\ 0 & r_{22} & \cdots & r_{2n} \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \cdots & r_{nn} \end{bmatrix}

其中,rij=⟨vj,ui⟩r_{ij} = \langle v_j, u_i \rangle 且 rii=∥wi∥r_{ii} = \|w_i\|。

5. 应用

在 OCREAD 中,Gram-Schmidt 过程用于初始化聚类中心,具体步骤如下:

  1. 使用 Xavier 均匀初始化方法初始化 K 个随机中心,每个中心包含 V 维,记为 C∈RK×VC \in \mathbb{R}^{K \times V}。
  2. 应用 Gram-Schmidt 过程将这些随机中心转换为正交基 EE:

    uk=Ck⋅−∑j=1k−1⟨uj,Ck⋅⟩⟨uj,uj⟩uj,Ek⋅=uk∥uk∥u_k = C_{k\cdot} - \sum_{j=1}^{k-1} \frac{\langle u_j, C_{k\cdot} \rangle}{\langle u_j, u_j \rangle} u_j, \quad E_{k\cdot} = \frac{u_k}{\|u_k\|}

6. 优势

正交归一化初始化的优势在于:

  • 减少冗余:正交基的性质使得每个聚类中心在特征空间中相互独立,减少了聚类中心之间的冗余,提高了聚类的区分度。
  • 提高性能:通过正交归一化初始化,模型可以更有效地学习节点嵌入和聚类分配,从而生成更具信息量的图级嵌入。